Solution Square (Global)
2024.10 - Present화면
개요
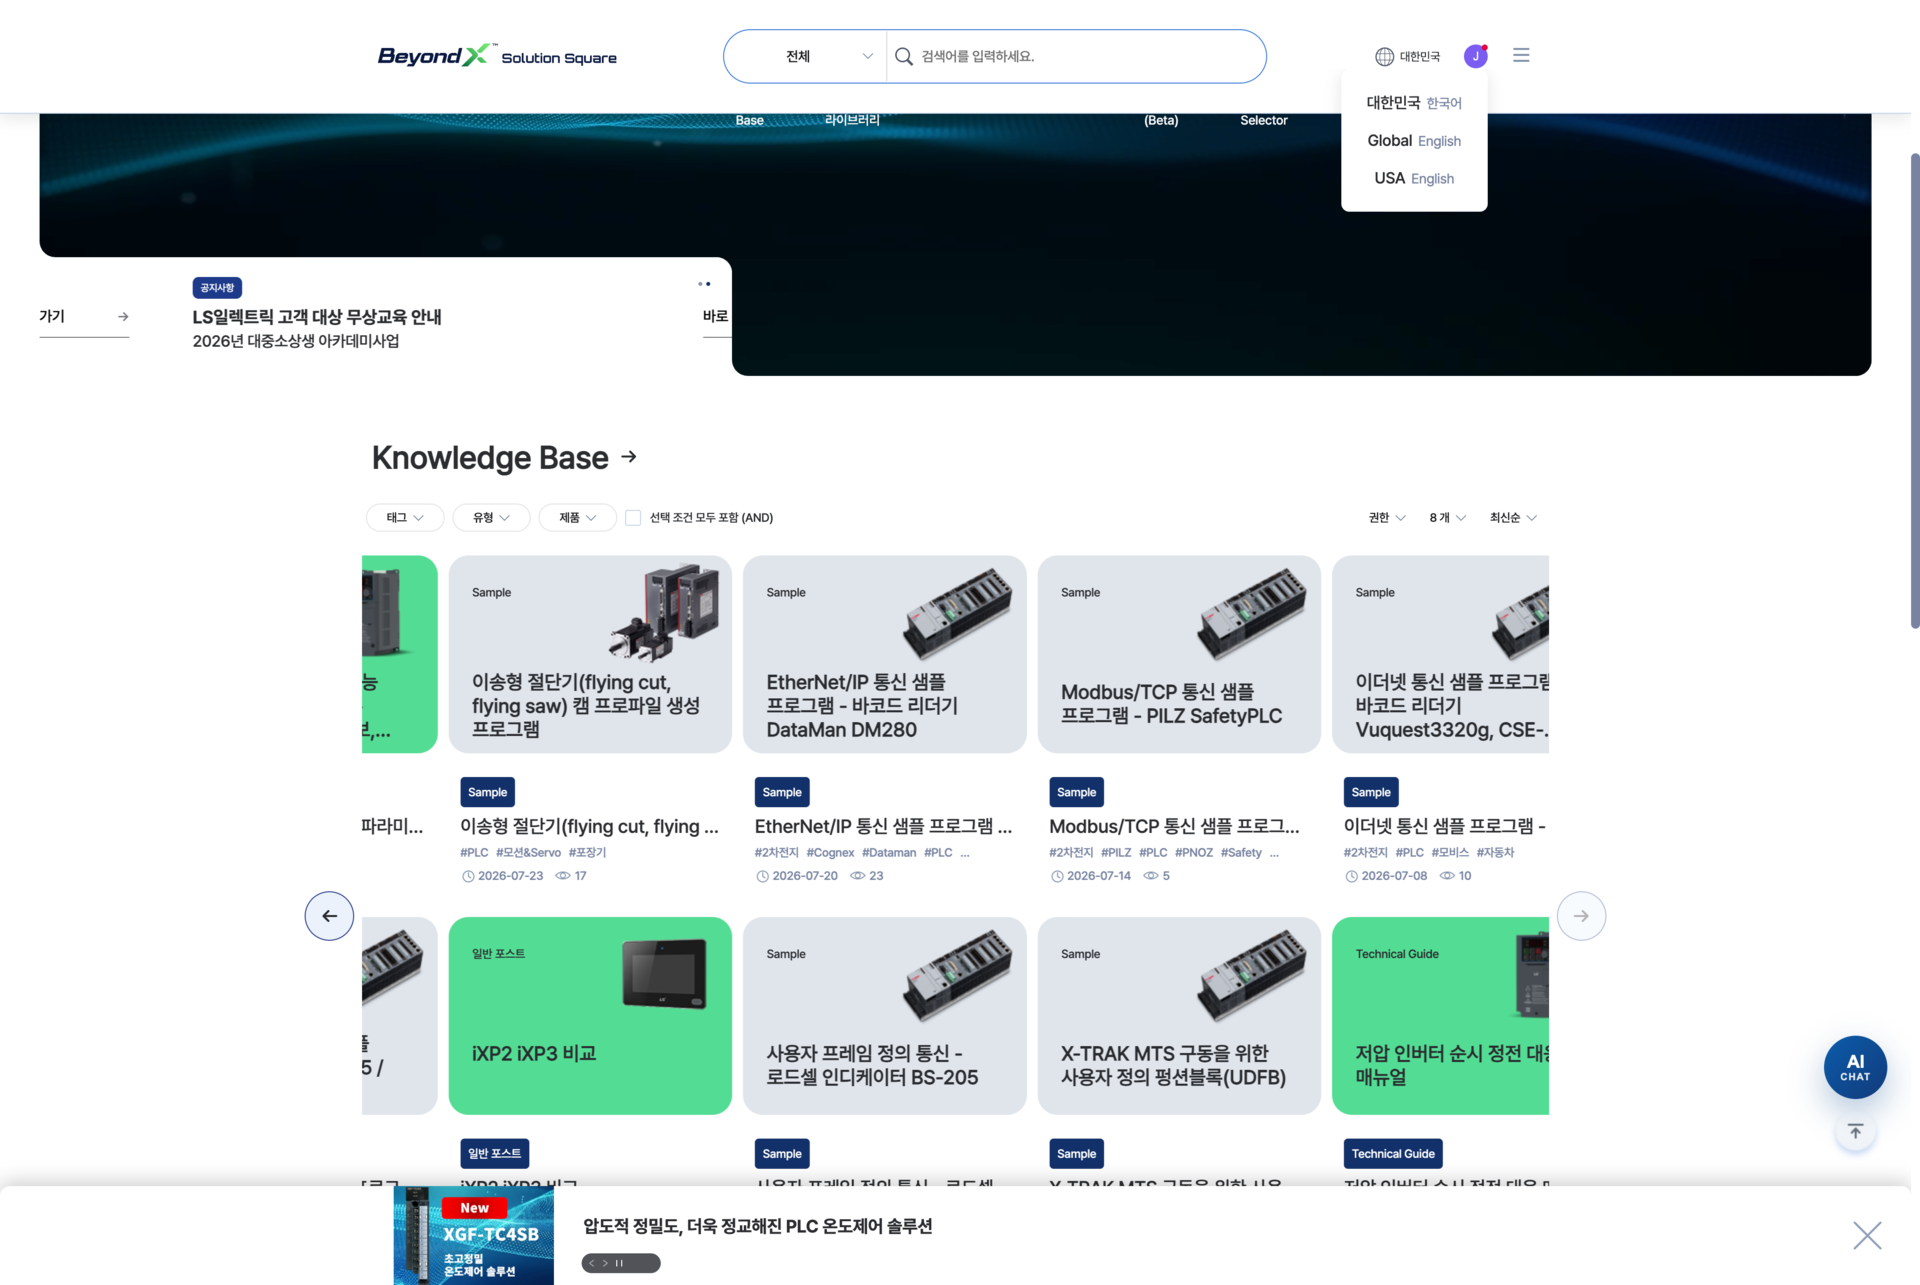
제품 정보와 기술 자료를 확인하고 필요한 제품을 선정하는 LS ELECTRIC의 글로벌 고객 포털입니다. 여러 지역과 언어를 지원하며 제품 선정 결과를 상담과 견적 요청이나 북미 고객 포털의 구매로 연결합니다.
역할과 기술스택
Java와 Spring 기반 백엔드 서비스와 프론트엔드 요청을 받는 API 서버(BFF)에서 비즈니스 로직과 신규 서비스를 개발했습니다. 기능 개발과 함께 런타임, 배포, 인증 등 공통 기반을 정비하는 역할을 맡았습니다. React와 TypeScript 프론트엔드에서는 제품, 대시보드, 검색, 사내 AI 어시스턴트(AI Chat) 개발에 참여했습니다.
Java, Spring Boot, React, TypeScript, Azure, Elasticsearch, Jenkins
성과 01
인증 로직 공통화
- 배경과 원인
- 고객 포털과 자동화 기기 상태를 모니터링하는 자산 관리 서비스는 같은 코드를 기반으로 개발됐습니다. 관리 주체가 달라지면서 인증 로직이 각 애플리케이션에 복사되어 따로 수정됐습니다. 한쪽의 수정이 다른 쪽에 반영되지 않아 두 애플리케이션의 인증 동작이 달라졌고 문제의 원인을 찾기도 어려웠습니다.
- 고민과 선택 이유
- 인증을 별도 서버로 분리하는 안을 먼저 검토했지만 배제했습니다. 운영 대상이 하나 늘고 모든 요청에 네트워크 홉이 붙는 비용을 두 애플리케이션 규모에서 감수할 이유가 없었습니다. 이미 공통 모듈을 두는 저장소 관례가 있어 그 관례를 따르는 쪽이 변경 폭이 가장 작았습니다. 추출은 세션, 인증 토큰과 SAML 유틸, JWT 순으로 나눴습니다. 한 번에 옮기면 문제가 생겼을 때 원인 범위가 넓어지기 때문입니다. 어댑터를 둬서 두 애플리케이션의 코드를 한 번에 바꾸지 않고 연결점만 교체했습니다.
- 결과
- 인증 로직 변경이 한 곳의 수정으로 끝나게 됐고 두 애플리케이션의 인증 동작이 같아졌습니다. 이관하면서 쓰이지 않는 코드와 중복 의존성을 정리해 JWT 라이브러리도 하나로 통일했습니다.
- 회고
- 레거시 개선은 한 번에 교체하기보다 기존 관례를 따라 변경 폭을 줄이고 검증할 수 있는 단위로 나눠 옮기는 쪽이 안전하다는 기준을 얻었습니다.
성과 02
알림 템플릿과 수신자 관리 시스템 구축
- 배경과 원인
- 이메일 알림 템플릿이 언어별 HTML 파일 54개로 하드코딩돼 있었습니다. 템플릿마다 요청 클래스와 엔드포인트가 따로 있어 알림 종류가 늘수록 코드가 선형으로 늘었습니다. 문구나 수신자를 바꾸는 데도 배포가 필요했습니다.
- 고민과 선택 이유
- 코드에 있던 템플릿을 데이터로 옮겼습니다. 문구와 수신자 변경을 배포에서 분리해야 관리자가 직접 다룰 수 있기 때문입니다. 템플릿은 채널, 이벤트 타입, 서비스 타입, 언어 네 축의 조합으로 식별해 기존 발송 방식의 새 알림을 템플릿 데이터 추가로 처리하게 했습니다. 수신자는 템플릿에 묶지 않고 별도 레지스트리로 분리해 조직이나 담당자가 바뀌어도 템플릿을 고치지 않게 했습니다. 개별 REST API 위에 관리 화면용 통합 API를 더해 화면에서 필요한 API 요청 횟수를 줄였습니다. 발송 구현체는 공통 템플릿 발송 하나로 모았습니다.
- 결과
- 관리자가 배포 없이 템플릿과 수신자를 관리하게 됐습니다. 이후 신규 기능의 알림은 발송 로직을 새로 만들지 않고 기존 로직을 재활용해 연결했습니다. 수신자와 발송 이력은 개인정보 암호화 대상으로 함께 정리했습니다.
- 회고
- 같은 형태의 코드가 반복해서 늘어나면 데이터 모델이 필요하다는 신호로 봅니다. 식별 기준을 데이터로 옮기면 새 요구를 코드 추가가 아니라 데이터 추가로 처리할 수 있다는 기준을 얻었습니다.
성과 03
개인정보 암호화와 검색 유지
- 배경과 원인
- 개인정보 보호 기준을 높이기 위해 이름, 전화, 이메일 같은 필드를 암호화해야 했습니다. 그런데 AES-GCM으로 암호화하면 값을 그대로 비교할 수 없어, 값이 정확히 같은 행을 찾는 기존 동등 검색을 쓸 수 없습니다. 암호화 저장과 운영에 필요한 검색을 함께 유지해야 했습니다.
- 고민과 선택 이유
- 암호화된 데이터를 저장하면서도 검색을 유지하도록 검색용 블라인드 인덱스를 함께 뒀습니다. 블라인드 인덱스는 원본 대신 단방향 변환값을 저장해 암호화된 상태에서도 같은 값을 찾게 하는 색인입니다. 암호문에는 키 식별자를 함께 저장해 복호화에 사용할 키를 찾도록 했습니다. 키를 교체하는 동안에는 이전 키와 새 키를 함께 유지해 기존 데이터도 읽게 했습니다. 반영은 쓰기 경로, 검색 경로, 과거 데이터 채우기 순으로 나눴습니다. 반대로 하면 채우는 동안 들어온 데이터가 빠지고 한 번에 하면 되돌릴 지점이 남지 않기 때문입니다. 전환 기간에는 평문과 암호문을 모두 읽게 해 단계 중간에 문제가 생겨도 서비스가 멈추지 않게 했습니다.
- 결과
- 개인정보 필드를 암호화한 상태로 저장하면서도 운영에 필요한 동등 검색을 유지했습니다. 전환 도중에도 화면은 그대로 동작했습니다. 과거 데이터를 채우는 작업은 중단 후 다시 실행해도 안전하도록 행 상태를 기준으로 재개하게 만들었습니다.
- 회고
- 보안 요구는 기존 기능을 유지하는 전환 경로까지 설계해야 운영 중인 시스템에 적용할 수 있습니다. 암호화 전환의 각 단계는 중단한 뒤 다시 실행할 수 있어야 한다는 기준을 얻었습니다.
성과 04
배포 자동화와 승인 기반 롤백
- 배경과 원인
- 세 모듈을 배포할 때마다 담당자가 앞 빌드가 끝나기를 기다렸다가 다음 배포를 순서대로 실행하고 있었습니다. 세 모듈을 병렬로 빌드하기에는 빌드 서버의 메모리 여유가 부족했습니다. 누가 언제 무엇을 배포했는지도 팀에 공유되지 않았습니다.
- 고민과 선택 이유
- 빌드 서버를 증설하는 대신 빌드는 한 모듈씩 순서대로 하되 파이프라인이 곧바로 다음 모듈로 넘어가게 구성했습니다. 배포 완료 여부는 롤아웃과 기동 성공 표시로 확인하고 같은 대상에 배포가 겹치지 않도록 동시 실행을 막았습니다. 롤백은 자동화하지 않고 담당자가 복구할 백업과 사유를 직접 지정해야 승인 절차가 시작되도록 했습니다. 배포 결과는 Teams와 이메일로 전달하고 주 알림 채널에 장애가 생기면 대체 경로에 결과가 남게 했습니다. 알림이 한 채널의 장애로 끊기면 자동화 자체를 신뢰할 수 없게 되기 때문입니다. 알림 실패가 배포 상태를 바꾸지 않도록 두 경로를 분리했고 알림 본문에는 자격증명과 내부 주소를 넣지 않았습니다.
- 결과
- 빌드 서버를 증설하지 않고도 담당자가 다음 배포를 실행하려고 대기하는 과정을 줄였습니다. 배포가 사람이 순서를 기억하는 일에서 정해진 단계를 따르는 절차로 바뀌었고 배포 결과는 Teams와 이메일로 자동 공유됩니다.
- 회고
- 알림은 성공 경로뿐 아니라 전송 실패 시의 대체 경로까지 설계해야 신뢰할 수 있습니다. 자동화할 대상은 작업 자체보다 작업 사이의 대기라는 기준을 얻었습니다.
성과 05
병합 전 코드리뷰와 자격증명 관리
- 배경과 원인
- 변경 검토의 품질이 리뷰어에 따라 달랐고 커밋 단위로 나뉜 코드리뷰에서는 놓치는 지점이 생길 수 있었습니다. 자격증명은 저장소와 명령 인자에 들어 있었습니다.
- 고민과 선택 이유
- 배포 전 변경 검토를 위해 AI 코드리뷰를 병합 요청에 연결했습니다. 병합 요청 검토와 push 후속 검사는 별도 트리거로 나누고 입력을 변경 diff와 배포 영향 경로로 제한했습니다. 매번 저장소 전체를 검토시키면 비용만 늘고 사람이 결과를 읽지 않게 되기 때문입니다. 승인까지 도구에 맡기지는 않았습니다. 자격증명은 저장소와 명령 인자에서 걷어내 시크릿 관리 공통 컴포넌트에서 주입받게 바꿨습니다.
- 결과
- AI 코드리뷰를 병합 요청에 연결해 병합 전에 보안 취약점과 잠재 장애를 검토하도록 했습니다. 자격증명이 저장소와 명령 인자에서 빠지고 주입 지점이 하나로 모였습니다.
- 회고
- 출력 마스킹은 우발적 노출을 줄일 뿐 경계가 되지 못한다고 봤습니다. 자격증명은 값 자체를 파이프라인 밖에서 관리해야 한다는 기준을 적용했습니다.
성과 06
빌드 환경과 캐시 관리
- 배경과 원인
- 빌드에 사용하는 도구 버전과 의존성 설치 기준을 프로젝트 설정에 맞춰야 했습니다. 도구 버전이나 환경 설정이 달라졌는데 이전 빌드 결과가 재사용되는 일도 막아야 했습니다.
- 고민과 선택 이유
- Node와 pnpm 버전이 프로젝트 설정과 일치하는지 검사하고 lockfile에 고정된 의존성으로 설치하도록 구성했습니다. 도구 버전과 환경 설정을 Gradle 빌드 입력에 포함해 값이 달라지면 다시 빌드하도록 했습니다. Jenkins 작업 공간을 정리할 때는 재사용할 캐시와 의존성 디렉터리를 보존하도록 범위를 조정했습니다.
- 결과
- 빌드에 사용하는 도구 버전과 의존성 설치 기준을 프로젝트 설정에 맞췄습니다. 도구 버전이나 환경 설정이 달라지면 다시 빌드하고 재사용할 캐시는 작업 공간 정리 뒤에도 남습니다.
- 회고
- 빌드 결과를 재사용하려면 결과에 영향을 주는 도구 버전과 환경 설정까지 빌드 입력으로 관리해야 한다는 기준을 적용했습니다.
성과 07
서비스 상태 진단
- 배경과 원인
- 서비스 상태를 진단할 때 프로세스 자체의 문제와 DB, 캐시 같은 외부 의존성의 문제를 구분해야 했습니다.
- 고민과 선택 이유
- 상태 진단을 프로세스가 살아 있는지, 요청을 받을 준비가 됐는지, 외부 의존성이 정상인지로 나눴습니다. 외부 의존성 장애가 곧바로 프로세스 재시작 판단으로 이어지지 않게 하기 위해서입니다.
- 결과
- 세 가지 상태를 구분하는 애플리케이션 코드와 운영 지침을 마련했습니다. 클러스터의 상태 검사 설정 적용은 별도 운영 범위입니다.
- 회고
- 상태 검사는 프로세스 문제와 외부 의존성 문제를 구분해야 재시작 여부를 판단할 수 있다는 기준을 적용했습니다.
성과 08
Java 11에서 21을 거쳐 25까지 단계적 런타임 현대화
- 배경과 원인
- 외부에서 개발한 모바일 앱이 회원 인증과 파일 관리 기능을 쓸 수 있도록 전용 API가 필요했습니다. 이 API를 Java 21과 Spring Boot 3 기반으로 새로 만들었습니다. 이로 인해 Java 11 모듈과 Java 21 모듈이 한 저장소에 공존했고 인증 코드도 여러 곳에 나뉘었습니다. 기존 런타임은 오래된 Java 버전에 묶여 있었고 프론트엔드 빌드 도구와 검색 클라이언트도 지원이 끝나가는 세대였습니다.
- 고민과 선택 이유
- Java 11에서 25로 한 번에 올리면 전체 작업 기간을 줄일 수 있었습니다. 하지만 런타임, 프레임워크, 의존성이 동시에 바뀌면 회귀 원인과 되돌릴 범위를 구분하기 어려웠습니다. 그래서 기존 모듈을 먼저 Java 21로 전환해 빌드를 통합하고 실행과 배포 호환성을 안정화했습니다. 이후 Java 25와 Spring Boot 4로 확장하면서 Jackson 3과 Elasticsearch Java Client 9.x로 전환했습니다. 코드 수정에 앞서 빌드 도구, 프레임워크, 서드파티 라이브러리, 베이스 이미지의 호환성을 한 표에 모았습니다. 컴파일과 테스트가 통과해도 실행 시점에 어긋나는 리플렉션, 직렬화, TLS, 타임존, 인코딩은 별도 검증 항목으로 뒀습니다.
- 결과
- JDK를 두 단계로 나눠 올리며 단계마다 되돌릴 수 있는 상태를 유지했습니다. 전환 뒤 프록시 환경에서 프로토콜이 다르게 인식돼 통합 로그인 흐름이 깨지는 문제가 드러났고 자체 처리를 걷어내 프레임워크 표준 설정으로 복구했습니다. 표준 포트가 아닌 환경의 서비스 식별자와 원 요청자 IP 전달 문제도 같은 방식으로 바로잡았습니다. 같은 기간에 프론트엔드 빌드를 CRA에서 Vite로, 검색 클라이언트를 7.x에서 9.x로 옮기고 기존 검색 질의가 같은 결과를 내는지 검증했습니다.
- 회고
- 런타임 업그레이드에서 작업이 많이 드는 곳은 버전을 올리는 일이 아니었습니다. 환경 차이로 달라진 동작을 찾아 복구하는 일이 더 큰 비중을 차지했습니다.
성과 09
SAML 표준 연동 전환과 SSO 확장 기반
- 배경과 원인
- 통합 로그인은 외부 인증을 받는 경로와 Solution Square가 인증 결과를 외부 서비스에 전달하는 경로를 구분해야 했습니다.
- 고민과 선택 이유
- 자체 구현을 계속 이어 붙이면 규격이 바뀔 때마다 직접 만든 코드가 따라가야 합니다. 그래서 기존 자체 처리를 프레임워크 표준 연동으로 옮기고 제공자별 설정을 레지스트리로 분리했습니다. Solution Square가 인증 결과를 다른 서비스에 전달하는 인증 제공자(IdP)로 동작하는 엔드포인트에는 전용 보안 체인을 뒀습니다. 해당 경로에 필요한 보안 규칙이 나머지 서비스에 영향을 주지 않게 하기 위해서입니다. 인증 응답의 서명과 토큰 표기를 정리하고 민감한 값이 로그에 남는 지점도 제거했습니다.
- 결과
- 제공자 설정과 인증 처리의 경계를 나눴습니다. 응답을 수신하고 검증하는 시험용 서비스(SP)도 만들어 실제 외부 서비스에 연결하기 전에 인증 응답과 로그인 흐름을 확인할 수 있게 했습니다. 새 연동을 검증할 기반도 마련했습니다.
- 회고
- 외부 서비스와의 인증 연동은 실제 환경에 연결하기 전에 응답과 로그인 흐름을 검증할 수단부터 마련해야 한다는 기준을 얻었습니다.
성과 10
룰 기반 제품 선정기 (Drive Panel Selector)
- 배경과 원인
- 고객이 사양에 맞는 드라이브와 패널 구성을 찾으려면 매번 기술 문의를 거쳐야 했습니다. 영업에서는 시스템 안에서 상담과 견적 문의까지 이어지는 도구를 요구했고 이를 다단계 선정기로 풀었습니다.
- 고민과 선택 이유
- 추천을 학습 모델이 아니라 명시적인 룰로 설계했습니다. 제품 구성은 옵션 사이 제약이 뚜렷한 공학 문제이기 때문입니다. 잘못된 구성이 견적과 수주로 이어지는 도메인에서는 예측보다 누구나 검증하고 설명할 수 있는 규칙이 맞습니다. 기동 방식 같은 선택지는 앞 단계에서 고른 드라이브 용량에 따라 좁혀지게 해 고객이 성립하지 않는 조합에 도달할 수 없게 했습니다. 결과 화면의 모델 이미지 렌더링, 고객 직접 입력 항목, 관리자 문의 내역 연동, 중복 문의 방지도 함께 만들었습니다. 선정기를 화면에서 끝내지 않고 상담과 견적 흐름까지 잇기 위해서입니다.
- 결과
- 고객이 기술 문의 없이 사양에 맞는 구성을 좁혀 결과 모델에 도달하고 그 자리에서 문의와 견적 요청으로 이어지는 흐름이 생겼습니다.
- 회고
- 추천처럼 보이는 요구도 옵션 사이의 의존성을 명시적인 룰로 정리하면 예측할 수 있게 풀립니다. 도구는 결과 화면에서 끝나지 않고 상담과 견적까지 이어져야 완성된다는 기준을 얻었습니다.
성과 11
온라인 제품 선정과 북미 고객 포털 구매 연동
- 배경과 원인
- 기존에는 영업사원과 오프라인 상담을 거쳐야 해 고객이 필요한 제품을 선정하기까지 시간이 오래 걸렸습니다. 고객이 온라인에서 직접 제품을 선정하고 구매까지 이어갈 수 있는 흐름이 필요했습니다.
- 고민과 선택 이유
- 내부 영업 및 제품 담당자와 제품 선정기를 기획하고 자체 요구사항에 맞춰 구현했습니다. 앞서 설명한 Drive Panel Selector의 상담과 견적 기능과는 별도로, Servo 제품 선택 화면에 북미 고객 포털 구매 연동을 구현했습니다. 구매 요청은 로그인 사용자와 요청 식별자를 기준으로 선택 품목과 수량을 저장했습니다. 구매 자격과 허용 조직을 확인한 뒤 유효 기간 안에 같은 내용으로 다시 보낸 구매 요청에는 앞서 저장한 결과를 반환했습니다. 같은 식별자로 품목, 수량, 순서를 바꾼 요청은 충돌로 처리했습니다. 같은 요청의 재전송과 내용이 달라진 요청을 구분해야 재시도에서도 구매 내용과 사용자 권한이 유지되기 때문입니다. 북미 포털로 이동하기 전에는 소유권과 만료를 다시 검사했습니다.
- 결과
- 고객이 온라인에서 제품을 선정하고 Servo 제품 선택 결과를 북미 고객 포털의 구매로 이어갈 수 있게 했습니다. 선정 제품과 구매 요청을 북미 고객 포털에 전달하는 흐름을 구현했습니다.
- 회고
- 온라인 구매 연동은 화면을 연결하기 전에 요청의 재사용, 내용 충돌, 권한, 만료를 어떻게 판정할지부터 정해야 한다는 기준을 적용했습니다.
성과 12
EAI 품목 데이터 수신의 중복 방지와 재처리
- 배경과 원인
- 구매 연동에 필요한 제품 코드 등 기초 데이터는 사내 시스템을 연계하는 EAI 인터페이스로 수신했습니다. 같은 요청을 다시 받아도 중복 반영하지 않으면서 실패한 건은 다시 처리할 수 있어야 했습니다. 여러 인스턴스가 같은 데이터를 동시에 처리하는 상황에도 대비해야 했습니다.
- 고민과 선택 이유
- 요청 식별자와 업무 키에 DB 유일성 제약을 두고 동시 저장이 충돌하면 기존 행을 다시 읽어 처리 상태를 판별했습니다. 성공한 건은 중복으로 분류하고 실패했거나 처리 유예 시간이 지난 건은 기존 수신 행으로 재처리했습니다. 여러 인스턴스의 동시 처리에는 DB 조건부 갱신으로 처리권을 확보했습니다. 결과를 기록할 때도 소유권 토큰을 검사해 이전 작업이 다른 작업의 처리 상태를 덮어쓰지 않게 했습니다. 늦게 처리된 과거 수신분이 이후 수신된 값을 덮어쓰지 않도록 업무 데이터에 마지막 반영 순번을 저장하고 그보다 큰 수신 순번만 적용했습니다. 대량 요청은 저장 전에 건수 상한을 검사해 초과 요청 전체를 거절했습니다. 일부를 저장한 뒤 거절하면 송신 측에서 어디까지 처리됐는지 판단하기 어렵기 때문입니다. 허용 범위 안에서는 한 건의 실패가 전체 배치를 되돌리지 않도록 건별로 처리했습니다.
- 결과
- 수신 테이블 저장뿐 아니라 실제 업무 데이터 반영 결과까지 확인해 응답에 담았습니다. 응답은 성공, 중복, 실패 건수를 구분합니다. 중복과 실패 항목에는 위치, 상태, 오류 코드, 오류 메시지, 재시도 가능 여부를 일관된 형태로 반환해 송신 측이 후속 처리를 판단할 수 있게 했습니다.
- 회고
- 연동에서 중복을 막는 장치와 실패한 건을 다시 처리하는 경로는 함께 설계해야 합니다. 중복만 차단하면 실패한 건을 복구할 방법이 사라지기 때문입니다.
성과 13
AI 검색 스트림의 연결 유지와 요청 수명 관리
- 배경과 원인
- 초기 요청과 응답 방식은 답변이 오래 걸리면 타임아웃이 났고, 이후 팀이 스트림 방식을 도입했습니다. 기존 스트림은 외부 응답을 공용 비동기 작업에서 기다렸지만 브라우저 연결 종료가 외부 요청의 취소로 이어지지 않았습니다. 답변 생성 중 응답이 없는 구간에 보낼 유지 신호도 없었습니다.
- 고민과 선택 이유
- 접수 이벤트와 유지 신호를 보내 응답이 없는 구간에도 연결을 관리하도록 했습니다. 느린 브라우저가 공용 타이머를 붙잡지 않도록 유지 신호의 실제 쓰기는 별도 작업으로 분리했습니다. 외부 응답을 읽는 작업은 동시 개수를 제한한 전용 실행기로 옮겼습니다. 브라우저가 연결을 끊거나 처리 기한을 넘기면 외부 응답 본문을 닫고 읽기 작업을 취소하도록 했습니다. 완료 이벤트를 받은 경우에만 성공으로 판정했습니다.
- 결과
- 유지 신호와 취소 시 외부 연결 정리 경로를 구현했습니다. 동시 요청 상한을 넘으면 즉시 거절하고, 완료 이벤트 없이 연결이 끝나면 실패로 처리합니다.
- 회고
- 스트림으로 전달 방식을 바꾸는 것만으로 장시간 요청이 끝나는 것은 아닙니다. 연결 유지, 외부 작업 취소, 동시 요청 제한과 완료 판정을 하나의 요청 수명 안에서 관리해야 합니다.